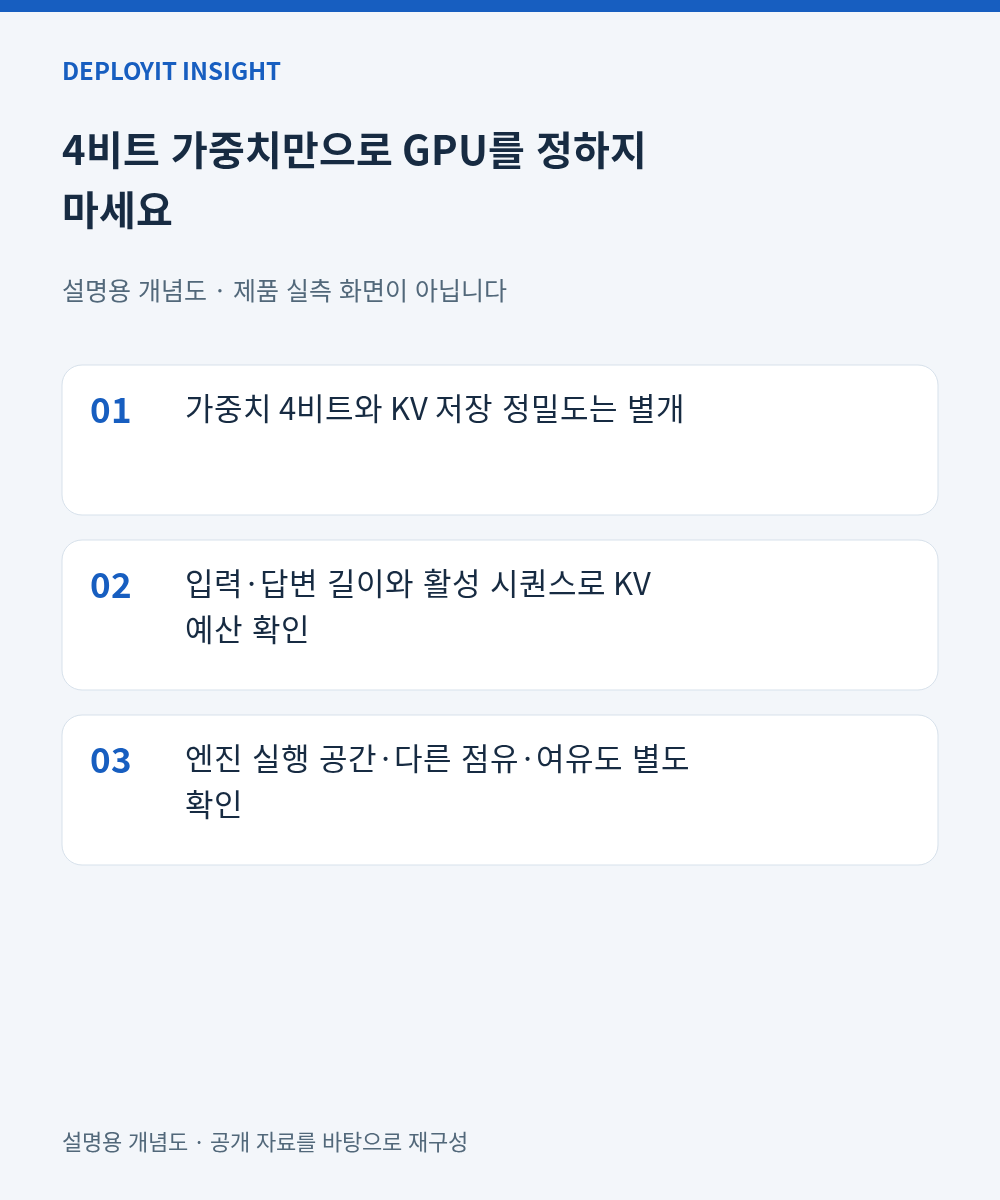
4비트 모델이라고 긴 문서용 GPU 용량까지 바로 정할 수는 없습니다. 가중치와 입력·답변의 중간 정보를 보관하는 KV 캐시는 따로 봐야 합니다.
모델을 줄여도 캐시 조건은 남습니다
모델 크기는 가중치 저장량의 출발점이고, 양자화는 그 저장 정밀도를 낮추는 방법입니다. vLLM 공식 문서도 가중치 양자화와 KV 저장 정밀도를 별도 설정으로 설명하므로, 4비트 가중치를 쓴다고 캐시까지 4비트라고 계산하면 안 됩니다.
8,192토큰의 순수 KV는 얼마일까요?
Qwen2.5-7B-Instruct 공식 설정은 28층, KV 헤드 4개이며 헤드 차원은 128입니다. 단일 GPU에서 KV를 BF16으로 저장하면, 입력과 생성 토큰 합계가 8,192개인 생성 작업 하나의 순수 KV 계산량은 448 MiB입니다.
같은 길이의 작업 네 개가 각각 캐시를 쓰면 1.75 GiB입니다. 전체 토큰 저장, 공유·오프로딩·슬라이딩·KV 양자화 없음이라는 가정이며, 엔진 실행·예약 공간을 제외한 산술 예시로 실측값이 아닙니다.
견적에는 문서 길이와 답변 상한도 적으세요
모델·엔진 버전, 가중치/KV 정밀도와 함께 대표 입력 길이·답변 상한·활성 시퀀스 조건을 적어 주세요. 입력이 길어지거나 함께 캐시에 남는 토큰이 늘면 필요한 KV 예산도 달라집니다.
구매 전에는 해당 GPU와 엔진의 지원 조합을 확인하고, 같은 조건에서 전체 점유와 생성 완료를 확인해야 합니다. 디플로이아이티는 공개 소개에서 AI 인프라 설계·구축·운영을 안내하며, 이 계산만으로 특정 GPU 용량이나 제품 지원을 확정하지 않습니다.
공식 근거: vLLM 엔진 인자 · Qwen 모델 카드 · 모델 설정 · GPU 지원 조건. 구성 조건 상담