vLLM은 켜졌는데 앱에서 모델을 찾지 못하나요? 앱이 접속할 주소에서 모델 목록을 읽고, 응답에 나온 ID를 앱 설정과 맞춰 보세요. 서버에서 localhost로 접속됐더라도, 다른 PC의 앱에는 사이트 설정에 정한 서버의 IP나 도메인을 입력해야 합니다.
새 Ubuntu VM에서 무엇부터 준비할까요?
VM에 GPU가 보이는지, 드라이버와 설치 계정 권한이 준비됐는지 확인하세요. 모델의 이용 조건·반입 경로·저장 공간, 앱에서 서버로의 허용 통신·DNS·TLS·인증도 먼저 정합니다.
사이트·노드·IP/FQDN·포트·MODEL_ID·모델 revision·VLLM_VERSION은 한 설정에서 관리하고 비밀값은 분리하세요. 검토한 버전의 격리 환경에서 uv pip install vllm==$VLLM_VERSION으로 설치하고, 선택 모델을 vllm serve "$MODEL_ID"로 띄우는 흐름입니다. 아래 연결 흐름과 명령은 설명용 예시이며 실제 설치·성능 측정 결과가 아닙니다.
목록의 ID로 채팅까지 확인하세요
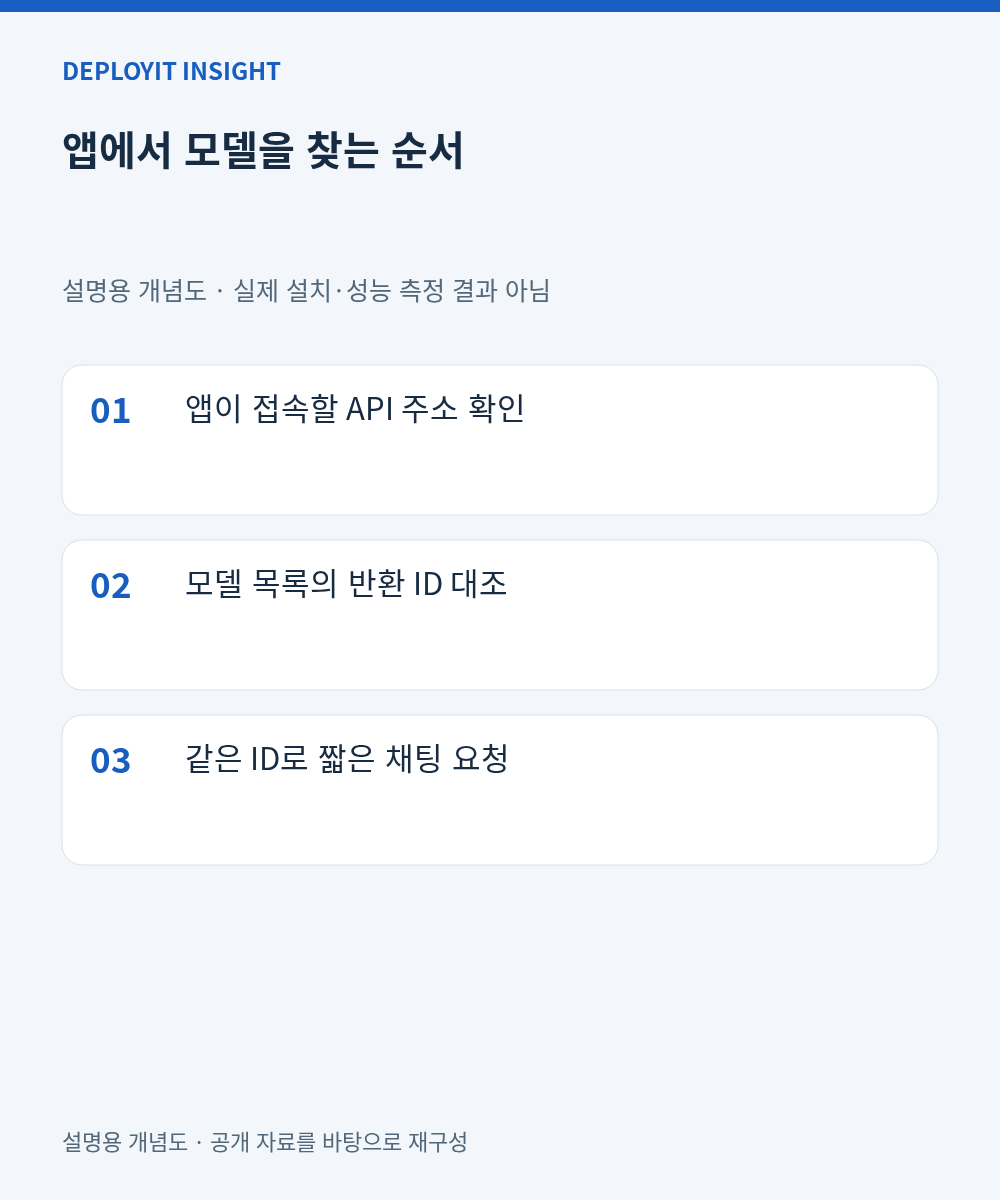
서버의 바인딩 주소와 앱의 접속 주소를 구분하세요. 앱의 BASE_URL에 https://<FQDN>/v1을 설정했다면 목록은 GET /models, 채팅은 POST /chat/completions를 이어 붙입니다. /v1을 두 번 넣지 마세요.
목록의 반환 ID를 MODEL_ID와 대조한 뒤 같은 ID로 짧은 채팅 요청을 보내 HTTP 상태와 choices 응답을 확인합니다. 목록이 보여도 채팅 성공은 별개이며, 선택한 생성 모델의 채팅 템플릿이 필요합니다. 한 번의 응답으로 업무 품질이나 동시 부하 통과를 판단할 수는 없습니다.
신규 설치본과 업데이트본을 구분하세요
신규 전체본에는 고정 의존성·모델·설정·기동 및 복구 절차를, 기존 업데이트본에는 변경분·호환 조건·설정 이관과 이전 실행본을 요구하세요. 변경 전 기존 개발·데이터·사용자 수정을 복구 가능한 백업으로 보존하고 복구시험을 준비합니다. 중앙 오류 로그 수집은 별도 설계하고 발생 시각·HTTP 상태·엔진과 모델 버전을 남기되 키·업무 원문은 제외하세요. 복구시험 담당과 확인 기준도 정하세요.
연결 설정뿐 아니라 설치본과 복구 절차의 인계 범위도 디플로이아이티 구축 상담에서 확인하세요. 공개 소개의 인프라 설계·구축·운영 이관 범위이며, 특정 vLLM 연동이나 구축 성과를 보장하지 않습니다.
공식 근거: vLLM 문서 v0.33.0의 GPU 설치·Quickstart·Online Serving, 회사 소개 (2026-11-04 확인).