총 tokens/s가 높으면 사용자 답변도 빨라질까요? 전체 처리량이 좋아져도 답변을 기다리는 시간이 줄었다고 볼 수는 없습니다. 같은 질문 조건에서 첫 출력과 답변 완료까지 걸린 시간을 함께 비교하세요.
GPU에 들어가는 것과 제때 답하는 것은 다릅니다
모델이 GPU 메모리에 적재됐다는 사실은 목표 응답시간을 만족하는 동시 인원을 보장하지 않습니다. NVIDIA 문서에서 총 TPS는 동시에 처리한 요청 전체의 출력 처리량입니다. 전체 처리량이 늘어도 개별 요청의 지연은 커질 수 있습니다.
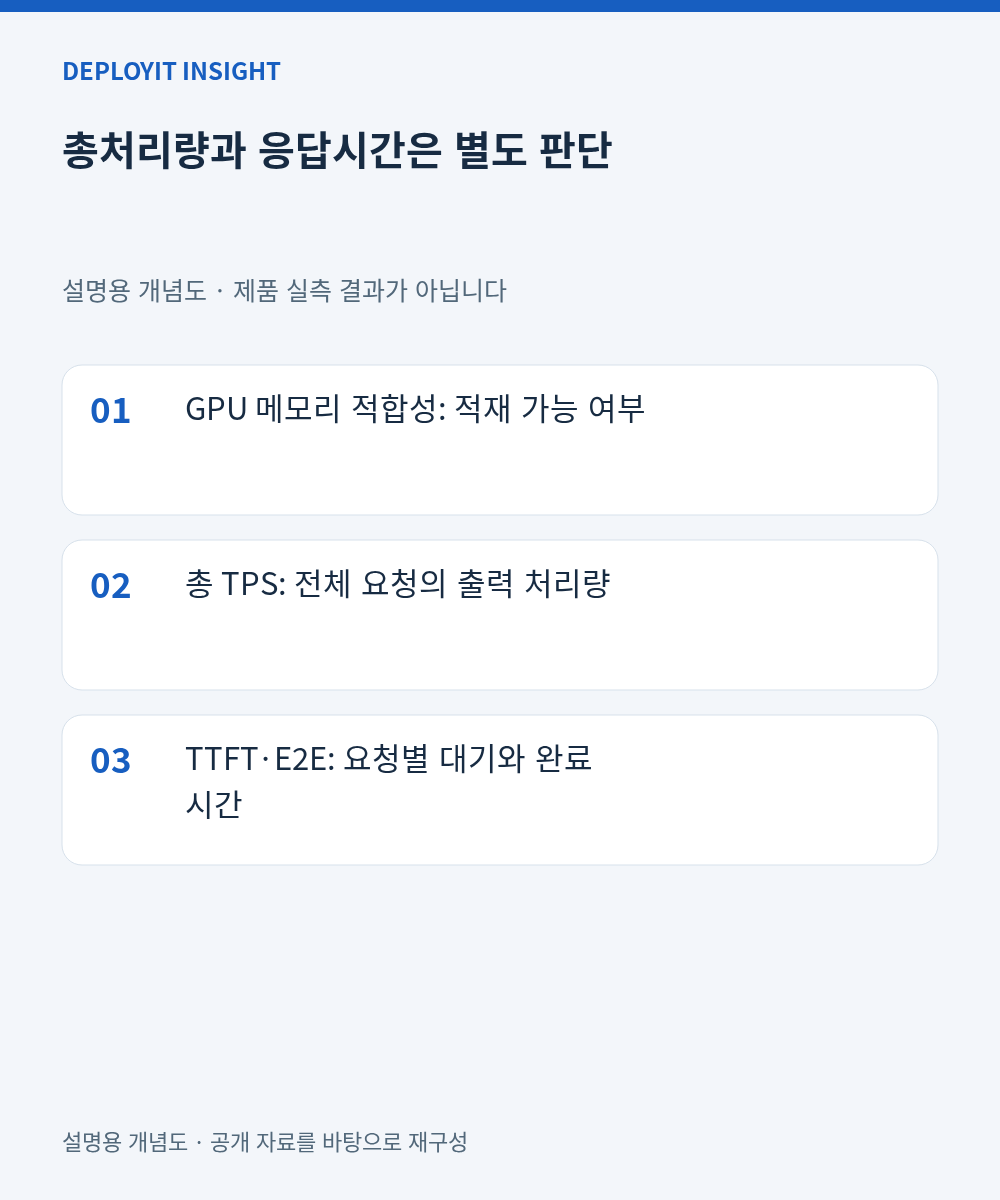
등록 인원 대신 활성 요청을 바꿔 확인하세요
등록 계정 수, 현재 접속자 수, 답변을 기다리는 활성 요청 수는 서로 다릅니다. 배치는 엔진이 함께 처리하는 요청 묶음으로, 활성 요청 일부만 포함할 수 있습니다. 일정한 활성 요청을 유지하는 시험과 수강생이 한꺼번에 질문하는 상황도 구분하세요.
모델 버전·정밀도·엔진·GPU·입출력 길이 분포·캐시·복제본 조건을 맞춘 뒤 활성 요청을 단계별로 늘려 보세요. 총 TPS와 함께 첫 출력까지의 시간(TTFT), 완료까지의 시간(E2E), 오류·대기를 기록합니다. 도구별 지표 정의도 맞추고, 미리 정한 지연·오류·답변 품질 기준을 함께 만족하는 범위를 고르세요.
GPU 교육도 등록 인원보다 실제 질문이 몰릴 때의 응답 확인이 먼저입니다. 디플로이아이티가 GPU 교육·실습 플랫폼으로 소개하는 AI FORGE를 검토할 때도 이 조건을 확인해 보세요. 여기서 설명한 시험은 운영 판단 방법이며 해당 제품의 성능 실측 결과가 아닙니다.
공식 근거: NVIDIA Metrics · Parameters and Best Practices. GPU·AI 인프라 도입 문의